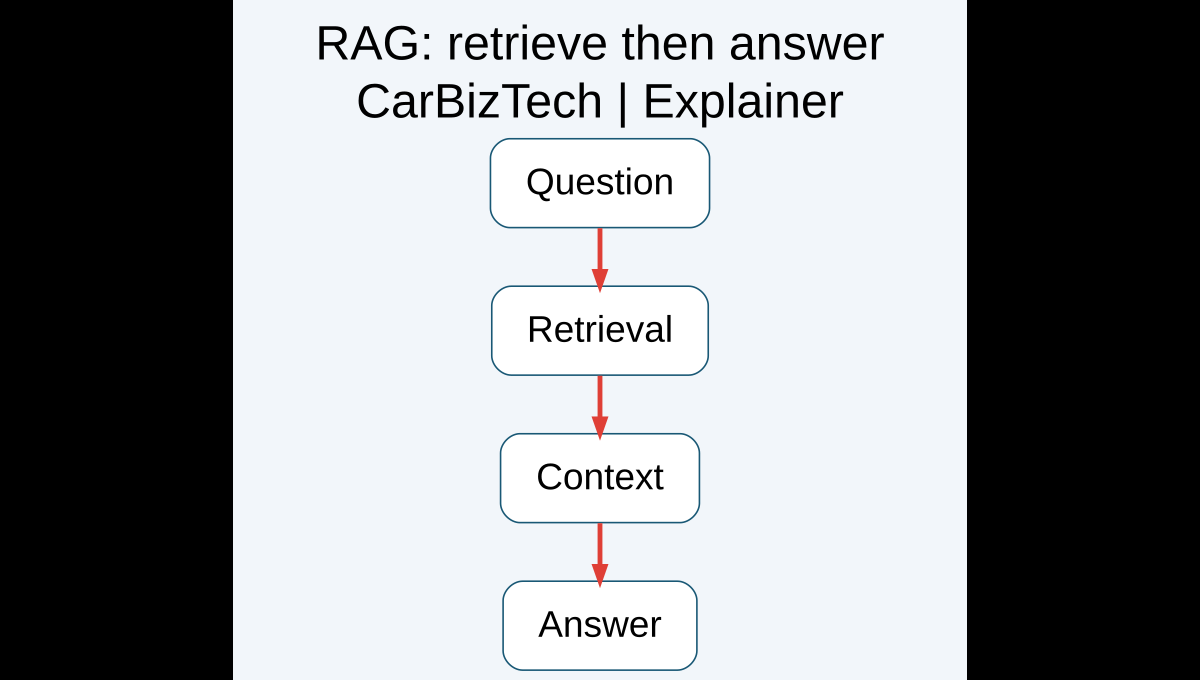
RAG คือการค้นข้อมูลที่เกี่ยวข้องก่อนส่งให้โมเดลภาษาใช้ประกอบคำตอบ เหมาะกับงานถามตอบจากเอกสารที่องค์กรมีอยู่ แต่คุณภาพยังขึ้นกับเอกสาร การค้น และการตรวจคำตอบ ไม่ใช่การรับประกันว่า AI จะตอบถูกเสมอ
ข้อมูลเดินทางอย่างไร
เริ่มจากจัดเตรียมเอกสาร สร้างดัชนีสำหรับค้น เมื่อผู้ใช้ถาม ระบบค้นส่วนที่เกี่ยวข้องแล้วส่งข้อมูลนั้นพร้อมคำถามให้โมเดลสร้างคำตอบ แนวทางนี้ช่วยเชื่อมการค้นกับการสร้างข้อความโดยไม่ต้องใช้การฝึกโมเดลใหม่เป็นขั้นตอนหลักของทุกการอัปเดตเอกสาร
เริ่มจากเอกสารขอบเขตเล็ก
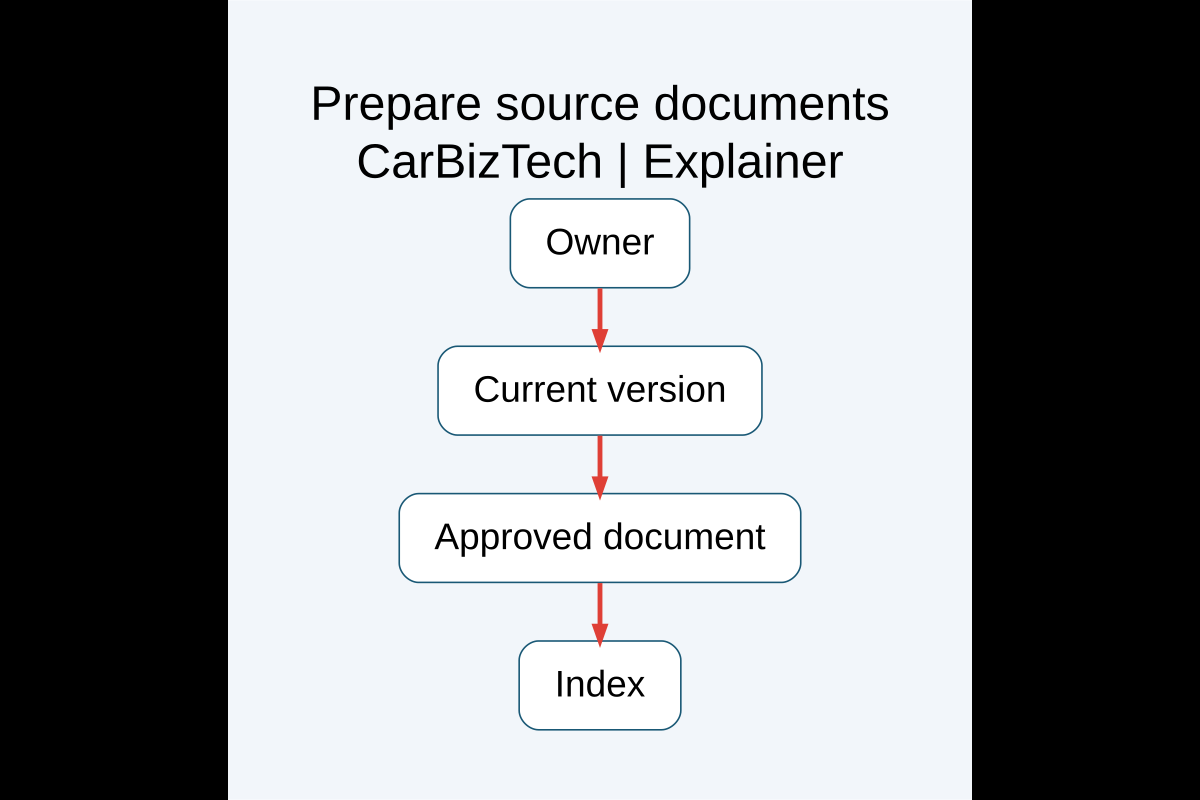
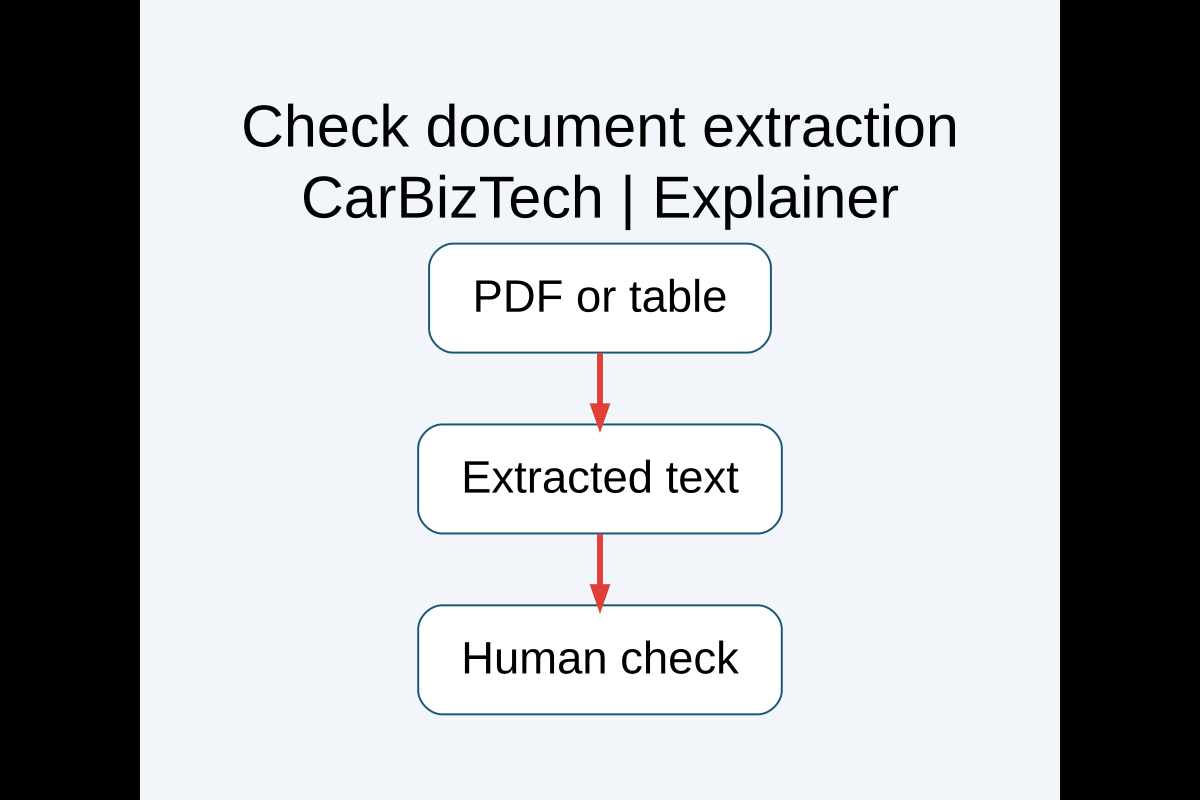
ตัวอย่างงานนำร่องคือคู่มือการใช้งานสินค้าหนึ่งกลุ่ม เลือกฉบับที่มีเจ้าของเอกสาร วันที่ปรับปรุง และสถานะอนุมัติชัดเจน แยกเอกสารที่เลิกใช้ และทดสอบว่าการอ่านตารางหรือข้อความจาก PDF ถูกต้อง
ออกแบบการประเมินก่อนเปิดใช้
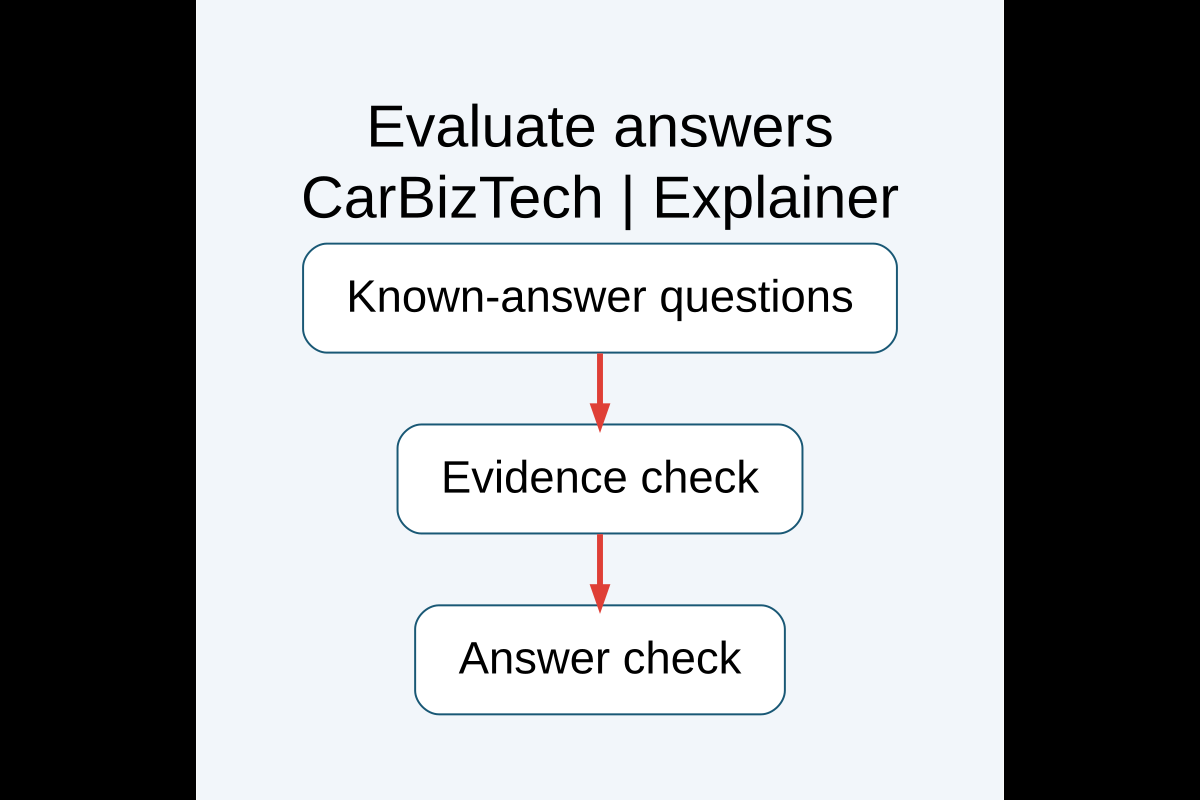
- เตรียมคำถามที่มีคำตอบอยู่จริง
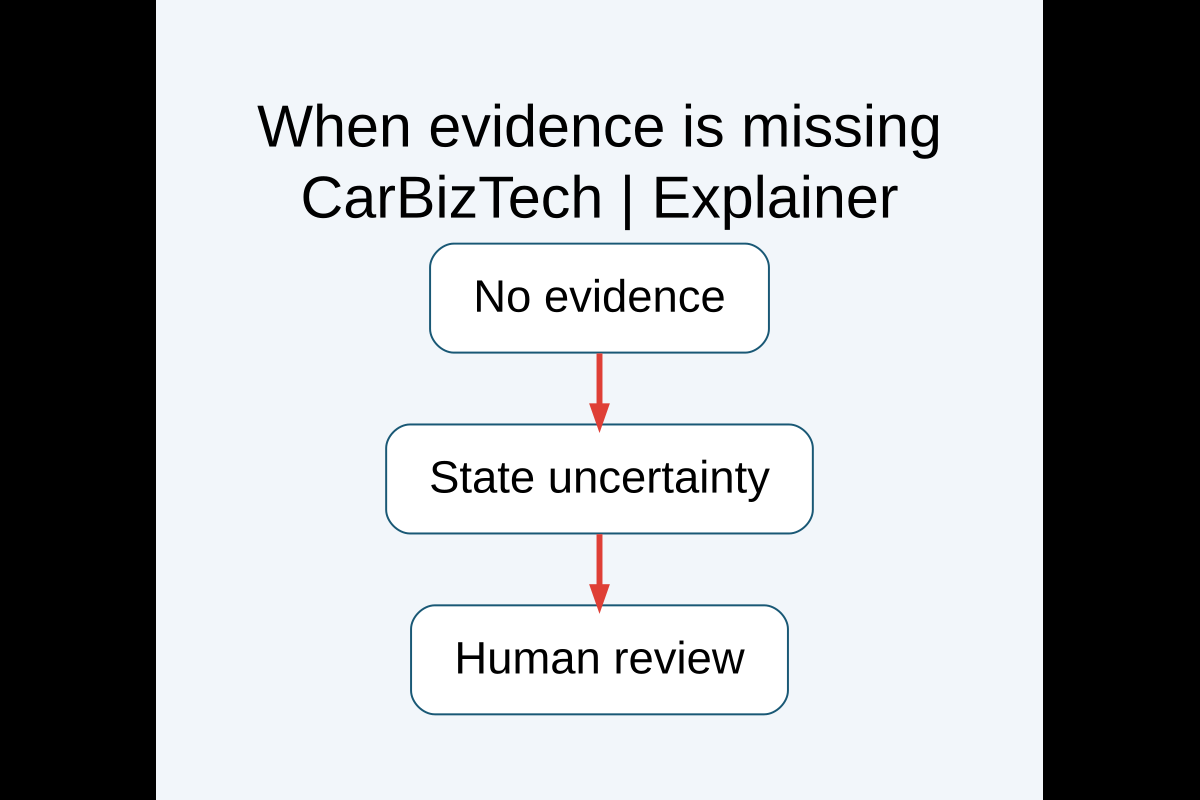
- เพิ่มคำถามที่ไม่มีคำตอบในเอกสาร
- ตรวจว่าข้อความอ้างอิงรองรับคำตอบจริง
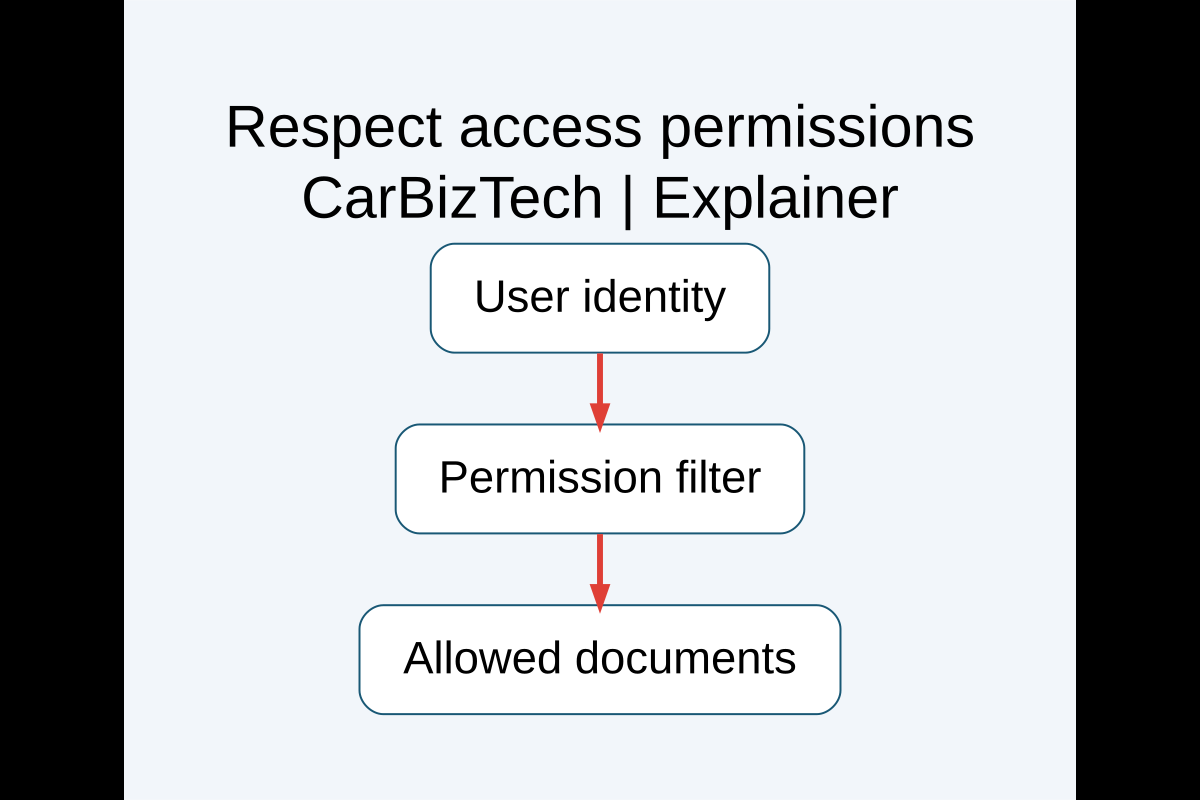
- ทดสอบบัญชีที่มีสิทธิ์เอกสารต่างกัน
- บันทึกข้อผิดพลาดเพื่อแก้การค้นหรือข้อมูลต้นทาง
กำหนดให้ระบบแจ้งเมื่อไม่พบหลักฐาน แทนการบังคับให้ตอบทุกเรื่อง และให้เจ้าของงานตรวจคำตอบก่อนนำไปใช้ในงานที่มีผลกระทบสูง
แผนภาพสรุปเพื่อใช้งาน
ภาพปกและแผนภาพในบทความจัดทำโดย CarBizTech เพื่ออธิบายแนวคิด ตัวอย่างในภาพเป็นแบบจำลอง ไม่ใช่ข้อมูลผลประกอบการหรือผลทดสอบจริง
คำถามที่พบบ่อย
RAG ทำให้ AI ไม่ตอบผิดเลยไหม?
ไม่ การค้นอาจเลือกข้อมูลผิดหรือโมเดลอาจตีความผิด จึงต้องประเมินทั้งหลักฐานและคำตอบ
ควรอัปโหลดทุกเอกสารทันทีไหม?
ควรเริ่มจากชุดที่ตรวจคุณภาพและสิทธิ์เข้าถึงได้ก่อน
มีลิงก์อ้างอิงแล้วถือว่าถูกไหม?
ยังไม่พอ ต้องเปิดดูว่าแหล่งนั้นรองรับข้อความจริงหรือไม่
อ้างอิง
Microsoft Learn: RAG และดัชนี · นิยาม RAG ของ NIST · บทความ IT และ AI